En cours : le film de 5 min
la mesure. préparation · 2026-09-27 → 2026-09-28 · Kaggle 2 × T4 + Blender 5.1 · 2 tests faits, 1 en cours · 0 € de GPU
Le verdict des essais Wan et LTX a changé la méthode. Trois tests en découlent : les styles et la continuité sont faits et ont leur page ; le film est en cours. Cette page dit où il en est. Aucune image LTX du film n'existe encore.
- run
- styles, continuité, film
- date
- 2026-09-27 → 2026-09-28
- machine
- Kaggle 2 × T4 · Blender 5.1.1 · OpenRouter (voix)
- durée
- 143,4 min de GPU pour les deux tests faits (87,6 + 55,8) ; film : pas encore de GPU
- coût
- 0 € de GPU · 0,59 $ de voix off
- journal
- releve.json
La nouvelle répartition du travail
Blender ne livre plus qu'une maquette sans textures, en couleurs unies, et sa carte de profondeur : la mise en page, les trajets, la caméra. Textures, costumes et lumière sont confiés à LTX-2.5, guidé par la profondeur. Plus besoin de soigner matériaux ni costumes dans la previz.
1. Les styles fait
Peut-on garder le mouvement de Blender et choisir le style ? Oui, à condition que le style arrive par une image de départ repeinte par Qwen-Image : seule, la consigne de style est ignorée. Meilleur clip : la photo documentaire, 8/10. Clips, planche et défauts : Garder le mouvement de Blender, choisir le style.
2. La continuité fait
Trois clips enchaînés dans la même scène se voient-ils ? Oui s'ils sont indépendants (saut ×12,6 à la jointure) ; presque pas si le clip suivant reprend la fin du précédent. Jusqu'à 10 s, une seule fenêtre de 241 images n'a aucune jointure et coûte le moins. Mesures, vidéos et recette : Enchaîner trois clips sans que ça se voie.
3. Un film de 5 min en cours
Le scénario est écrit, en version 2 depuis le 28/09 : « Carthage: The City Before the Fire », 10 séquences, 22 plans, 300 s (7 200 images à 24 i/s), 14 prises continues pour 13 coupes, la plus longue de 52 s ; narration de 686 mots.
film/scenario/scenario.md et scenario.json (v2)
La voix off est enregistrée : MiniMax speech-2.8-hd par OpenRouter, voix « English_Trustworth_Man », choisie parmi trois pour sa voix grave et son débit (2,6 mots/s). 53 phrases, 285 s de narration posées sur la ligne de temps (262,6 s de parole), −16,1 LUFS. Coût : 0,59 $ tout compris (essais et contrôles), dont ≈ 0,41 $ pour le texte final. Une transcription à l'aveugle n'a trouvé ni mot manquant ni mot répété.
film/voix/minutage.json, controle_transcription.json · film/scenario/scenario.json (voix_off.cout_usd) · compteur de crédits OpenRouter, rapport de l'agent voix
Chaque prise sera habillée selon la recette de la continuité : une seule fenêtre jusqu'à 10 s, des fenêtres enchaînées avec reprise de 17 images et fondu au-delà. Sa profondeur garde des bornes lissées d'un bout à l'autre, pour éviter un saut de luminosité aux raccords.
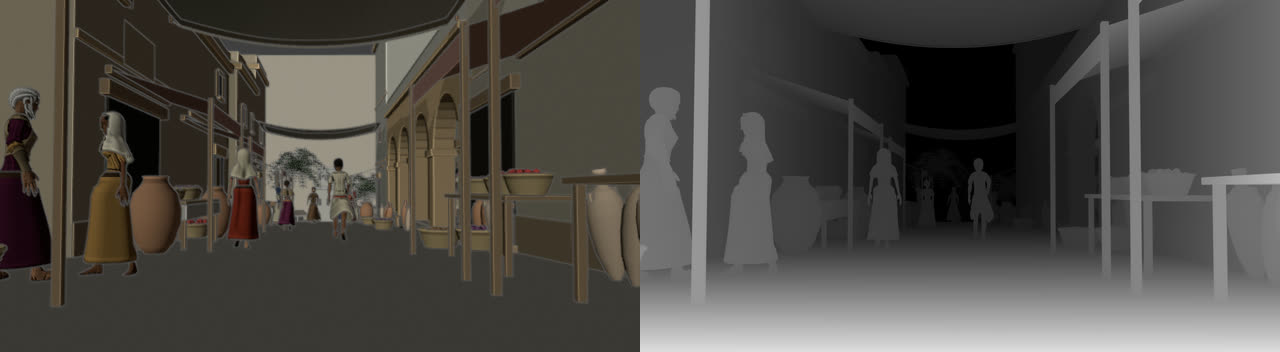
Ce que Blender livre désormais : un aperçu Workbench en couleurs unies, sans texture (à gauche), et sa profondeur (à droite), seule entrée de LTX. Previz Blender de ce projet ; figurants de Quaternius, 7 modèles CC0, « Witch » et « Worker » en CC BY 3.0 (détail).
L'outil de previz est prêt et rapide, même sans carte graphique dédiée : 33,8 s pour construire le décor, 0,55 s par image d'aperçu en Workbench, 0,45 s par image de profondeur en EEVEE à 8 échantillons.
film/rendus/essai_rue/temps.json
Où en est le film : la previz Blender est en construction — décors et plans se rendent au fil de l'eau. Viendra ensuite l'habillage par LTX. Les résultats seront publiés ici une fois relus.